以前看AI生成的跳舞视频,总忍不住笑出声——人是站稳了,脚底却像踩了溜冰鞋;挥手动作很到位,下一秒肩膀突然‘咔’一下跳变,活像关节生锈。不是模型不会画人,是它压根没把‘动’当一回事。它只懂一帧一帧拼pose,不懂身体怎么从A点自然过渡到B点:重心怎么移、脚掌何时落地、膝盖怎么缓冲、转身时手臂怎么带出惯性……这些细节,才是真实运动的灵魂。
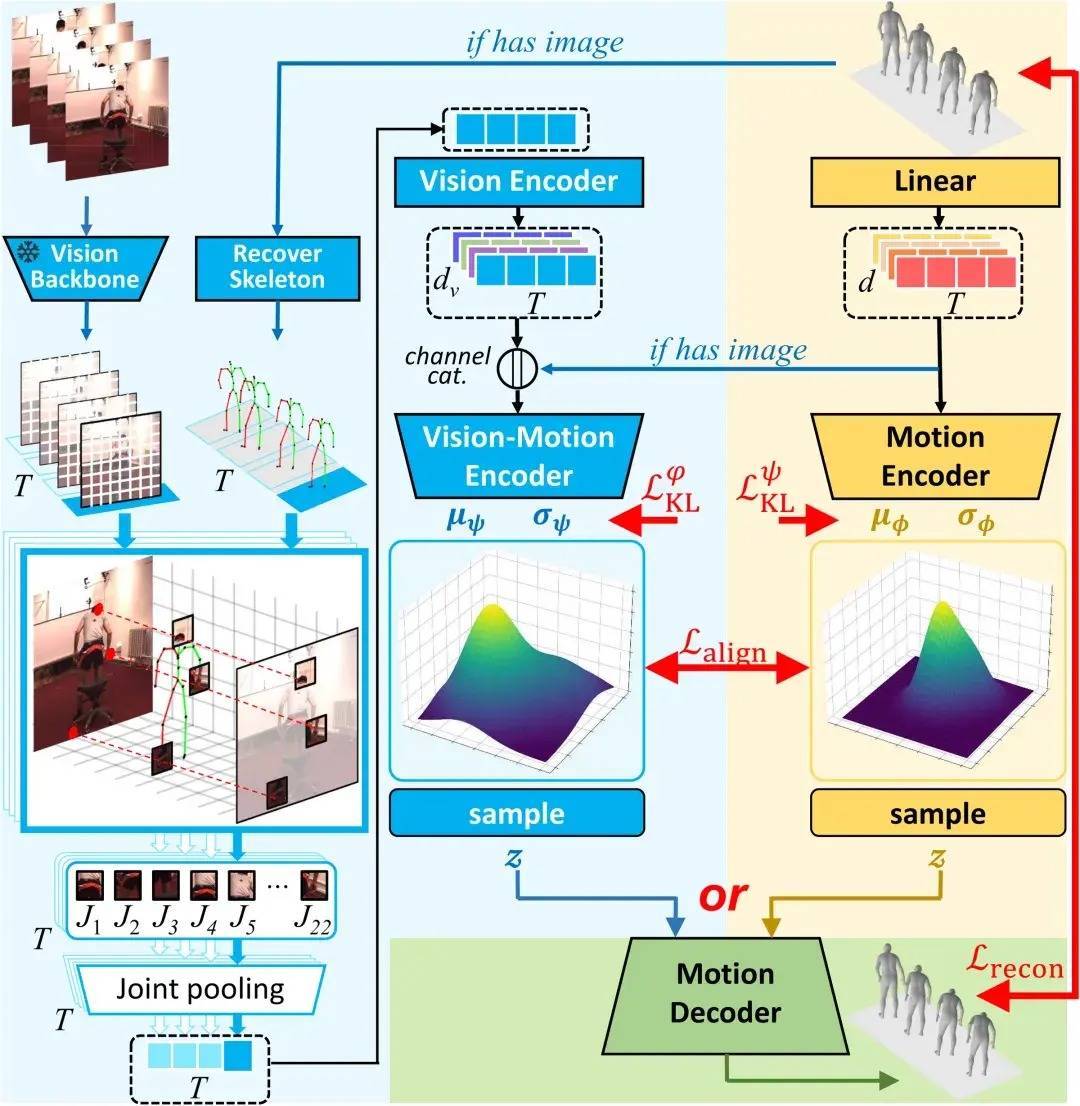
UniMotion不一样。它不把动作切成离散token塞进语言模型里凑数,而是直接把连续运动当成和文字、图像平起平坐的‘第三模态’。论文里一句话很实在:‘逐帧合理≠连起来自然’。北大、东华、华南理工团队用CMA-VAE把人体运动编码成连续latent,再通过双路径嵌入器,一边抓语义(比如‘起跳→腾空→落地’三阶段),一边保细节(某个脚踝在第0.37秒的旋转角度)。Text走自回归老路,Motion和RGB则走连续流式生成——模态分工明确,主干共享理解,既不打架,也不将就。
更妙的是它的实用性。一个模型,七项任务全包圆:文字生成动作、动作预测下一步、视频驱动动作编辑、跨视角动作迁移、甚至纯文本条件下的长期动作生成(比如‘慢跑5秒后突然停下并转身’)。训练时靠视觉后验对齐提升鲁棒性,推理时甩开图像也能跑——轻量、灵活、真懂人。这不是又一个炫技demo,而是第一次让人感觉:AI终于开始‘看’动作,而不只是‘数’关键点。
这背后其实藏着一个被很多人忽略的真相:过去十年,动作生成领域的论文发了不少,但真正能落地进健身房、康复中心、动画工作室的,凤毛麟角。为啥?因为大多数模型在实验室里跑分漂亮,一到真实场景就露馅——比如让AI给中风患者生成康复训练动作,它可能给出一个“理论上可行”但膝盖超负荷30%的蹲起轨迹;再比如给游戏公司做动作库,生成的“格挡→反击”连贯性看着还行,可放到120帧引擎里一放慢,手腕滞后0.2秒,手感直接垮掉。UniMotion没绕开这些坎,而是把临床运动学数据、生物力学约束、甚至专业舞者的肌电图(EMG)采样都喂进了训练流程。华南理工团队公开的消融实验里有个细节:去掉脚踝力矩约束模块后,生成的走路动作在仿真环境中摔倒率上升了47%——不是玄学,是实打实的物理守门员。
更接地气的是它的部署方式。不用GPU服务器,手机端就能跑通基础版本。东华大学合作的那家老年社区服务中心,已经用它把医生口述的“八段锦第三式,抬手要缓、下按要沉”实时转成带关节角度标注的动作流,投到教室大屏上,老人跟着动,系统还能语音提醒“您左肩抬高了5度,稍降一点”。没有传感器,不戴设备,纯靠摄像头+轻量模型。这不是科幻,是去年11月已在松江试点上线的功能。
当然,它也不是万能钥匙。目前对极高速爆发动作(比如拳击直拳的0.15秒出拳阶段)还原度还有提升空间;多人体交互(两人击掌、拉扯)的时序耦合也还在攻坚。但关键在于,它第一次把“动作理解”从“画得像不像”的视觉任务,拉回了“做得对不对”的功能任务轨道。北大团队在arXiv评论区里写了一句很朴实的话:“我们没教AI跳舞,我们教它先别让人摔跤。”
说到底,技术温度不在参数量多大,而在它愿不愿意蹲下来,看看普通人抬手够不到药瓶时,肩膀到底需要转几度。
顺配网提示:文章来自网络,不代表本站观点。